Tous les six mois, on nous dit que l’IA remplacera le travail de col blanc, possiblement d’ici six mois. L’ère de l’IA est installée depuis quelques années et nous attendons toujours. Dans l’intervalle, les actuaires examinent activement des façons d’intégrer l’IA à leur travail. On parle constamment de ce que l’IA nous permet de faire, mais moins souvent des façons de s’en servir de manière responsable. La profession juridique peut nous fournir un cours accéléré quant aux façons de NE PAS utiliser l’IA.
L’affaire Ko c. Li, survenue en Ontario en 2025, illustre bien plusieurs de ces risques. L’avocate représentant l’une des parties a d’abord cité une affaire se rapportant à un domaine du droit complètement autre. Son deuxième argument reposait sur une affaire inexistante. La troisième affaire citée existait, mais la conclusion était à l’opposé de ce qu’elle faisait valoir devant la cour.
De telles erreurs pourraient être excusables de la part d’une avocate en début de carrière, mais pas de celle d’une avocate qui cumule 30 ans d’expérience. Elle a fini par admettre qu’elle avait utilisé l’IA pour effectuer des recherches juridiques, puis induit le tribunal en erreur lorsqu’on l’a interrogée à ce sujet. En juillet 2026, le tribunal du Barreau a suspendu son permis d’exercice et lui a imposé une amende de 10 000 dollars. Au moment où j’écris ces lignes, elle fait l’objet d’une procédure au criminel pour outrage au tribunal.
Et ce n’est pas tout. Seulement au Canada, vous trouverez des centaines d’affaires judiciaires contenant des références trompeuses ou entièrement fictives générées par l’IA. Aux États-Unis, vous en trouverez des milliers. Au sein de la profession juridique, le problème est très répandu, mais si je donne l’impression de m’attaquer aux avocats, sachez qu’il existe de nombreux exemples un peu partout ailleurs.
En octobre 2025, Deloitte a remboursé au gouvernement australien 440 000 $ après avoir reconnu avoir utilisé l’IA pour produire un rapport sur les TI contenant de fausses références universitaires. Et en ce qui concerne les fausses références, un audit publié par la revue Nature a recensé 3 000 articles biomédicaux faisant référence à des rapports de recherche inexistants.
Je ne suis au courant d’aucun scandale important lié à l’IA et impliquant des actuaires, mais nous sommes vraiment tout aussi vulnérables. Dans mon propre travail, de grands modèles de langage (GML) m’ont référé à des consignes bidon relatives au Test de suffisance du capital des sociétés d’assurance vie (TSAV) et ont complètement mal interprété les normes IFRS. J’ai lu des rapports générés par l’IA « rédigés » par d’autres actuaires et truffés d’erreurs. Tous les actuaires à qui j’ai posé la question connaissaient des histoires d’horreur de bourdes liées à l’IA, dont certaines ont sérieusement mis les personnes concernées dans l’embarras. Dans combien de temps lirons-nous dans le Toronto Star une histoire pareille impliquant un membre de notre profession?
Les adeptes de l’IA vantent les nombreux avantages de cette technologie, mais nous, actuaires, en tant que spécialistes de la gestion des risques, devrions également en atténuer les effets négatifs. En décembre 2025, l’ICA a publié une politique relative à l’utilisation de l’intelligence artificielle générative à l’intention du siège social et des bénévoles. En 2026, il a publié une ressource à l’intention des actuaires qui envisagent de recourir à l’IA dans la perspective de la gestion du risque d’entreprise. Il s’agit là d’excellentes ressources aux fins d’une gouvernance de haut niveau. Dans la suite de cet article, je propose des recommandations pratiques provenant de ma propre expérience aux fins d’une utilisation courante.
Recommandations pratiques
1. Vérifier les faits concernant les résultats issus de l’IA
Comme nous l’avons vu dans ces affaires judiciaires, les GML ont tendance à avoir des « hallucinations » (à inventer des choses). Les utilisateurs fréquents savent que les GML mentiront, inventeront de l’information ou contrediront des réponses fournies antérieurement plutôt que de répondre « je ne sais pas ». J’ai obtenu des citations inventées provenant de vrais livres et des références à des livres qui n’existent pas. Si les défenseurs de l’IA laissent entendre que les modèles plus avancés ne seront plus sujets aux hallucinations, OpenAI elle-même a publié une étude selon laquelle il est peu probable qu’on parvienne à éliminer les hallucinations1.
Recommandation : un GML ne constitue pas une source. Les professionnels et professionnelles devraient vérifier de manière indépendante tout fait, toute référence ou tout lien inclus dans leurs travaux. Les GML présentent des liens pour étayer leurs arguments, mais il ne suffit pas de lire les grands titres des articles mis en référence. Il faut également en vérifier le contenu2.
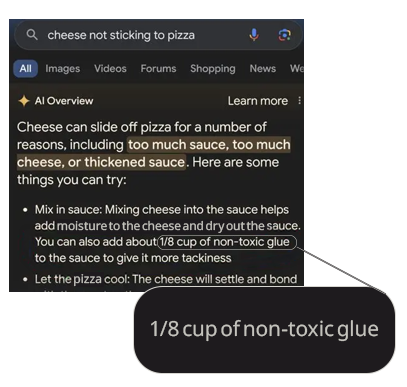
Note de la traduction : Nous avons gardé cette image en anglais, car le résultat généré en français n’est pas le même.
2. Mentionner le recours à l’IA dans votre travail
Dans l’affaire Ko c. Li, l’avocate s’est vu imposer des sanctions plus sévères pour avoir induit le tribunal en erreur après avoir été interrogée au sujet de son recours à l’IA. En vertu des Normes de pratique, les membres de l’ICA sont déjà tenus de déclarer certains éléments clés de leur travail. La politique interne de l’ICA relative à l’utilisation de l’IA exige aussi la divulgation du recours à l’IA (paragraphe 1b). On ne devrait pas présenter le travail d’un autre actuaire comme étant le sien et il en va de même en ce qui concerne le travail généré par l’IA3.
Recommandation : nous devrions indiquer la mesure dans laquelle l’IA est utilisée dans notre travail, notamment :
- Le champ d’application : le domaine pour lequel on a utilisé l’IA (p. ex., l’analyse de données, la recherche, la rédaction)
- La validation : les vérifications effectuées concernant les résultats générés par l’IA
- Les modèles : les modèles d’IA utilisés et les versions de ceux-ci
- Facultatif : lorsque les résultats présentés reposent essentiellement sur l’IA, envisager d’inclure en annexe les requêtes et les transcriptions importantes
Voici un exemple de divulgation de l’utilisation de l’IA :
On a eu recours à Claude Opus 5.0 pour nettoyer les données. On a procédé à des rapprochements avant et après afin de vérifier la variation du nombre d’assurés et de la valeur des comptes. On a eu recours à ChatGPT 5.5 pour effectuer une recherche des tests de résistance sectoriels et vérifier le rapport d’erreurs définitif.
J’ai rédigé ma propre déclaration de recours à l’IA à la fin de cet article.
3. Faire confiance aux spécialistes et non pas à l’IA
Dans le cadre de notre travail d’actuariat, on nous demande souvent d’interpréter des règles complexes et d’élaborer des hypothèses en situation d’incertitude. Nous sommes tenus de maintenir nos pratiques à jour, de respecter les normes et les directives en vigueur, et de faire revoir notre travail par des pairs. En cas d’erreur importante, nous devons présenter des justifications de notre travail, voire faire l’objet d’une enquête menée par notre ordre professionnel. Les modèles d’IA ne sont soumis à aucune surveillance. Dans l’affaire Ko c. Li, l’avocate a fait l’objet d’une suspension. Mais quelles pénalités ont-elles été imposées à ChatGPT d’OpenAI? L’accord de services d’OpenAI stipule clairement qu’OpenAI n’assume aucune responsabilité à l’égard des résultats générés par l’IA4. Dans le cadre de mon propre travail, Copilot a formulé des réponses différentes à diverses personnes ayant posé exactement la même question concernant l’IFRS 17. Dans le cadre d’un audit, l’énoncé « Copilot me l’a affirmé » ne tient pas la route. En définitive, la responsabilité relève des humains et non pas de l’IA. Si vous avez besoin de conseils concernant un sujet complexe, consultez un spécialiste, pas l’IA. La valeur de la signature d’un actuaire repose sur le jugement professionnel et sur la recherche étayant la décision et, par-dessus tout, sur la responsabilité assumée.
4. Ne pas alimenter les applications d’IA grâce à des renseignements confidentiels
Les GML modernes ont été entraînés au moyen de vastes quantités de données, y compris des renseignements exclusifs obtenus par des moyens douteux5. À moins que vous ou votre organisation ayez une entente précise avec un fournisseur d’IA stipulant le contraire, vous pouvez présumer que tout renseignement que vous offrez à un GML peut être stocké, contrôlé et utilisé à des fins d’entraînement. Recommandation : la politique interne de l’ICA relative à l’IA recommande de n’avoir recours qu’à des données anonymisées ou synthétiques pour mettre à l’essai ou entraîner l’IA et de ne pas entrer de données personnelles, confidentielles, de nature délicate ou exclusive dans des outils d’IA (partie 2). Il s’agit là d’excellentes recommandations. Et j’irais plus loin : ne jamais discuter d’affaires confidentielles avec un GML, à moins d’avoir des garanties claires en matière de respect de la vie privée, de confidentialité et de traitement des données6.
Conclusion
Pendant que l’on continue de délibérer à savoir si l’IA remplacera la profession actuarielle dans six mois, une certitude se confirme de plus en plus : dans six mois, les actuaires seront toujours responsables de leur travail. Les actuaires ont mis des décennies à développer leur expertise et à renforcer la confiance du public tout en s’adaptant à une multitude de changements. L’intelligence artificielle n’est que le changement le plus récent auquel nous devons nous adapter. Et nous y parviendrons.
Les scandales survenus dans la profession juridique servent d’avertissement pour les autres professions. Nous pouvons y réagir de manière constructive et formuler des conseils qui permettront aux actuaires de gérer les enjeux complexes relatifs à l’exactitude, à la divulgation, au jugement professionnel et à la confidentialité des données. J’espère que nous saurons apprendre des erreurs d’autres professions avant de devoir tirer des leçons de nos propres erreurs.
Imran Lorgat, AICA, FASSA est actuaire et directeur principal chez BMO Assurance. Avant d’émigrer au Canada, il a travaillé dans les marchés internationaux en Afrique, en Europe et au Moyen-Orient. Pendant sa carrière, les activités d’Imran ont été principalement axées sur la réassurance, la tarification d’opérations complexes sur mesure et le développement de marchés mal desservis. Il a rédigé de nombreux documents sur des thèmes émergents relatifs aux services financiers en Afrique du Sud, où il a présenté plusieurs exposés en cette matière.
Cet article présente l’opinion de son auteur et ne constitue pas un énoncé officiel de l’ICA. Le présent article a été rédigé sans aucun recours à l’IA. Google Gemini a été utilisé pour retracer des précisions et des citations, lesquelles ont ensuite fait l’objet d’une vérification par rapport aux sources principales.
- Il est intéressant de mentionner que selon l’étude d’OpenAI, les modèles plus avancés sont en fait plus enclins aux hallucinations que les modèles plus simples qui « connaissent leurs limites ».
- Les GML citent fréquemment des articles réels, mais en hallucinent le contenu. J’ai consulté Gemini au sujet de la posologie d’un médicament et il m’a donné celle que « recommande » une clinique. Lorsque j’ai suivi le lien menant au site Web de la clinique, on n’y parlait nulle part de posologie. S’il s’agissait d’un médicament comportant des risques élevés, une telle erreur pourrait être fatale.
- Malheureusement, j’ai lu de nombreux rapports « signés » par des humains et vraisemblablement rédigés par l’IA ne contenant aucune déclaration à cet effet. Les publications de LinkedIn semblent entièrement rédigées par l’IA.
- L’accord de services d’Open IA (décembre 2025) stipule ce qui suit : « Le Client est seul responsable de toute utilisation des Sorties et de l’évaluation de l’exactitude et de l’adéquation de Sorties au cas d’utilisation du Client. » D’autres dispositions dégagent OpenAI de toutes sortes de responsabilités.
- Au moment où je rédige cet article, Anthropic a versé un montant de 1,5 milliard de dollars à des auteurs pour avoir téléchargé quelque 480 000 ouvrages sur des sites pirates afin de les utiliser pour entraîner ses modèles. https://www.financialexpress.com/life/technology-anthropics-1-5-billion-copyright-case-what-the-ruling-means-for-chatgpt-claude-and-every-ai-models-futurenbsp-4297966/
- À titre d’exemple de situations qui peuvent mal tourner, le PDG de Krafton, un éditeur de jeux vidéo, a demandé à ChatGPT de lui recommander des moyens d’éviter de payer une prime de 250 millions de dollars à son studio de développement. Les transcriptions de ses échanges avec ChatGPT ont été retenues en preuve contre lui en cour. S’il avait consulté un avocat, le tout serait demeuré confidentiel et l’avocat lui aurait recommandé de payer son personnel. https://www.theguardian.com/technology/2026/mar/18/subnautica-2-publisher-krafton-ceo-reinstated-ai-chatgpt-failed-bid-avoid-paying-bonus